> ## Documentation Index
> Fetch the complete documentation index at: https://docs.monad.xyz/llms.txt
> Use this file to discover all available pages before exploring further.
# RaptorCast
> 用于区块传播的多播消息投递协议
## 概要
RaptorCast 是在 [MonadBFT](/zh/monad-arch/consensus/monad-bft) 中用于将块提案从领导者发送到验证者的专门化多播消息投递协议。块提案使用 [RFC 5053](https://datatracker.ietf.org/doc/html/rfc5053) 中的 Raptor 编码转换为纠删编码块。每个块通过两级广播树发送给所有验证者,其中第一级是一个单一的非领导者节点。每个非领导者节点负责作为不同块集合的第一级节点;块分配的比例等于该验证者的质押权重。
因此,RaptorCast 在保持拜占庭容错的同时,利用整个网络的全部上传带宽将块提案传播给所有验证者。
请查看 Category Labs 的这篇[**博客文章**](https://www.category.xyz/blogs/raptorcast-designing-a-messaging-layer),了解 RaptorCast 数据传输、纠删编码和广播策略的完整介绍。
## 引言
以下 RaptorCast 的技术描述涉及参与共识的 **验证者** 节点之间的区块传播。特别地,[到全节点的区块传播](#secondary-raptorcast-full-node-block-propagation)的处理方式不同。
在 MonadBFT 中,领导者需要将块提案发送给每个验证者。将块提案从领导者传送到网络的其余部分是高性能分布式共识中具有挑战性的问题之一,因为块提案很大,而网络并不可靠。
考虑以下两种解决此问题的朴素方法:
1. 从领导者直接向每个验证者发送消息。这是最简单的方法,但由于块提案很大,这将给领导者带来非常高的上传带宽要求——例如,10,000 笔交易,每笔 200 字节,就是 2MB。
2. 从领导者向少数几个对等节点发送消息,每个对等节点再重新广播给少数几个对等节点。这种方法会降低领导者的上传带宽要求,但会增加到所有节点的最大延迟,并且如果一些对等节点是拜占庭的且未能转发消息,则存在消息丢失的风险。
RaptorCast 是解决此问题的多播消息投递协议,在带宽需求、延迟和容错之间提供最佳的权衡。RaptorCast 是专为 MonadBFT 开发的,并满足以下要求。
在下面的讨论中,"消息"是块提案,"消息发起者"是领导者。
## 设计需求
* 如果 `2/3` 超级多数的质押权重是非故障的(诚实且在线),则保证向所有参与的共识节点可靠地投递消息。
* 验证者的上传带宽要求与消息大小线性成比例,且与参与验证者的总数无关。[^1]
[^1]: 这在参与验证者(近似)等额质押时成立。在质押权重分布(非常)不均的情况下,我们需要偏离等额上传属性,以在每一种三分之二质押权重对应于非故障节点的可能场景下保持可靠的消息投递。
* 最坏情况下的消息传播时间是任意两个节点之间最坏情况单向延迟的两倍。换句话说,消息传播到所有预期接收者的过程,发生在网络中两个最远节点之间往返时间 (RTT) 内。
* 消息以可配置的冗余量传输(由节点运营者选择)。增加的冗余可缓解数据包丢失并降低消息延迟(接收者可以更快、更迅速地解码)。
## RaptorCast 的工作原理
### 纠删编码
消息由消息发起者进行纠删编码。纠删编码意味着消息被编码为一组数据块,可以从任何足够大的数据块子集中解码出消息。
RaptorCast 使用的具体编码是 [RFC 5053](https://datatracker.ietf.org/doc/html/rfc5053) 中记录的 Raptor 编码的一个变体,加上一些 Monad 特定的修改,以
* 提高小消息的编码效率
* 降低消息编码的计算复杂度(代价是解码复杂度略有增加)
### 消息和数据块分发模型
RaptorCast 为每个数据块使用两级广播树。消息发起者是树的根,第一层是一个非发起者节点,第二层是每个其他节点。
编码消息的每个数据块可能对应不同的广播树,但当前实现对编码消息数据块空间的连续范围使用相同的广播树。
下图说明了这种数据块分发模型:
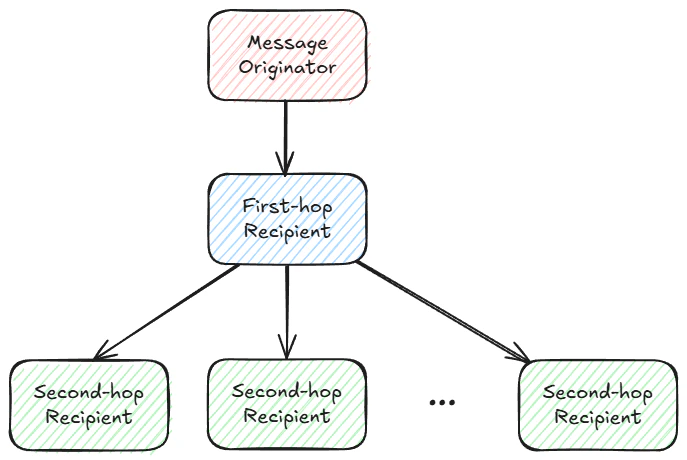
两跳 Raptorcast 广播树的通用视图。
使用两级广播树可以最小化消息投递的延迟。树的每一级都具有网络中任意两个节点之间单向延迟的最坏情况延迟(网络的"延迟直径"),因此 RaptorCast 下最坏情况的投递时间是网络的往返时间。
### 容错
RaptorCast 直接在 UDP 之上运行,每个 UDP 数据包含一个消息数据块。
请注意,广播树是单向的。与 TCP 不同,RaptorCast 不包含用于树中下游节点检测数据包丢失并请求重传的恢复机制,因为这会违反延迟预期。为了弥补这一点,RaptorCast 以冗余的方式传输消息,冗余因子由消息发起者根据网络的预期数据包丢失率选择。
例如,在以下假设下:
* 20% 的网络数据包丢失
* 网络中最多 33% 是故障或恶意的
那么消息发起者应在最坏情况下预期 (1 - 0.2) \* (1 - 0.33) 或约 53.6% 的数据块到达预期目的地。为了抵消这种最坏情况的损失,发起者应发送 1 / 0.536 - 1 或大约 87% 的 *额外* 数据块。
使用的默认 [MTU](https://en.wikipedia.org/wiki/Maximum_transmission_unit) 是 1480 字节。减去 RaptorCast 头部开销(默克尔树深度为默认的 6),每个数据包剩余 1220 字节用于编码的 Raptor 负载。一个 2 MB 的区块映射为 2e6 / 1220 = 1640 个源数据块。使用当前的冗余因子 2.5,4100 个编码数据块将按质押权重比例分发给其他验证者。
如果有 100 个验证者,这 4100 个编码数据块将被分成 99 个(排除发起者)不同的数据块范围,领导者将为每个验证者启动一个对应其唯一数据块范围(和负载)的广播树。如果验证者具有相等的质押,每个验证者将在连续范围内收到 4100 / 99 = 41 个数据块。
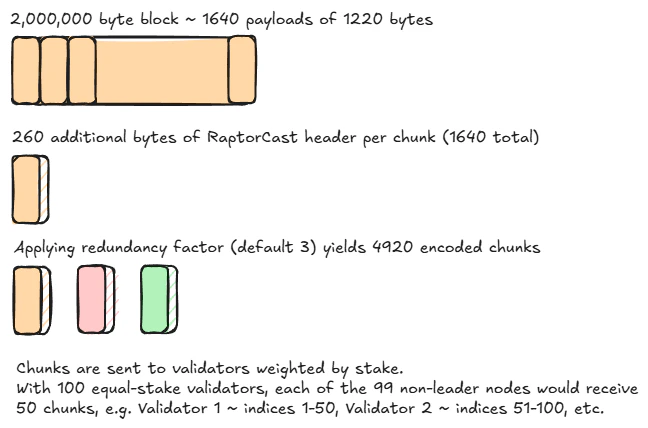
一个 2 MB 的区块被分成数据块、扩展并分发。
请注意,两阶段分发模型允许参与共识的节点即使在与消息发起者的直接网络连接间歇性或完全故障时,也能接收到消息的一份副本。
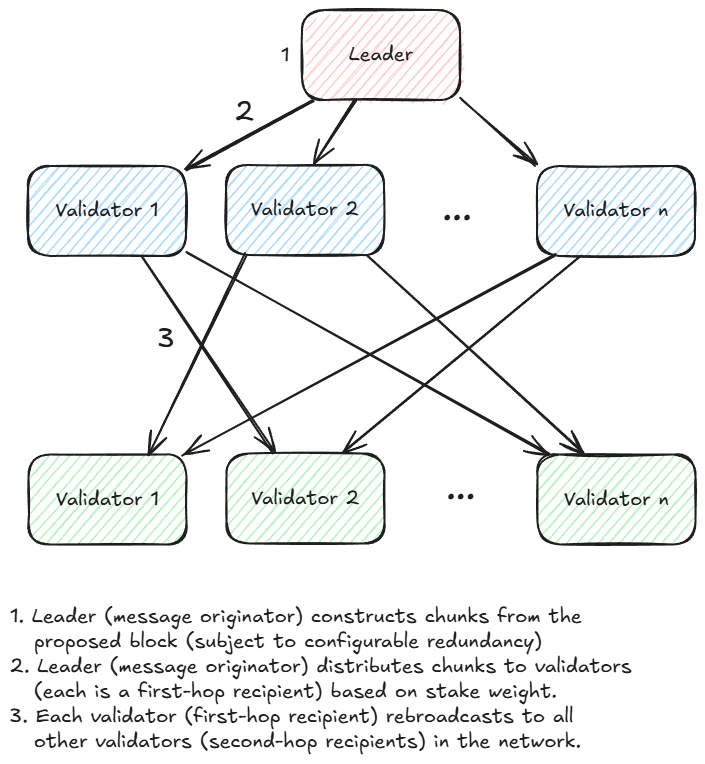
RaptorCast 用于将纠删编码的数据块从领导者发送到每个验证者。
消息发起者(领导者)通常[^2]按质押权重将生成的数据块分发给第一跳接收者。例如:
* 验证者 1 的质押为 1
* 验证者 2 的质押为 2
* 验证者 3 的质押为 3
* 验证者 4 的质押为 4
当验证者 1 是领导者时,它将发送:
* 生成的数据块中 2 / (2 + 3 + 4) 给验证者 2
* 生成的数据块中 3 / (2 + 3 + 4) 给验证者 3
* 生成的数据块中 4 / (2 + 3 + 4) 给验证者 4
领导者 *目前* 以连续范围发送数据块,但目前正在开发工作以启用更细粒度的分发。使用新算法,单个或小得多的数据块集将随机地(按质押权重加权,无放回)发送给第一跳验证者。这种方法可以更好地利用网络,因为所有验证者都可以在数据块到达时开始处理并发送以进行重新分发(启动第二跳)。
[^2]: 当所需数据块的数量足够小时(例如 12 个数据块分发给 100 个验证者),纯质押权重分发方案可能会失效。这个边界情况正在积极处理中。
### 数据块传输完整性
发起者对每个编码数据块签名,因此广播树中的中间节点(第一层)可以在转发之前验证编码数据块的完整性。
此外,源数据块的数量 `K` 编码在消息中。对于给定的 `K`,接收者当前接受范围为 0 到 `7 * K - 1` 的编码数据块。这给了发起者足够的自由来指定高度冗余(最多 7 倍),同时也限制了流氓验证者的网络垃圾邮件潜力。
为了在许多数据块上分摊生成和验证这些签名的成本,RaptorCast 将编码消息数据块的连续范围聚合到可变深度的默克尔树中,并为每个默克尔树根生成一个签名。
## RaptorCast 的其他用途
RaptorCast 不仅用于以数据块形式从领导者广播区块。
### 交易转发
交易转发,例如从全节点到接下来的三个验证者主机,通过 RaptorCast 执行,受益于其速度和健壮性。在这种情况下,只需要一跳——接收者不应重新广播。
### 次级 RaptorCast - 全节点区块传播
RaptorCast 也用于向全节点传播块提案。如[全节点配置](/zh/node-ops/full-node-block-delivery)中所述,每个参与的验证者创建一个以自身为根的次级 RaptorCast 网络,利用全节点作为接收者。如果全节点被验证者 **优先化**,或者它们以 **public** 模式运行并被选择算法选中,则会被添加到验证者的次级 RaptorCast 组中。
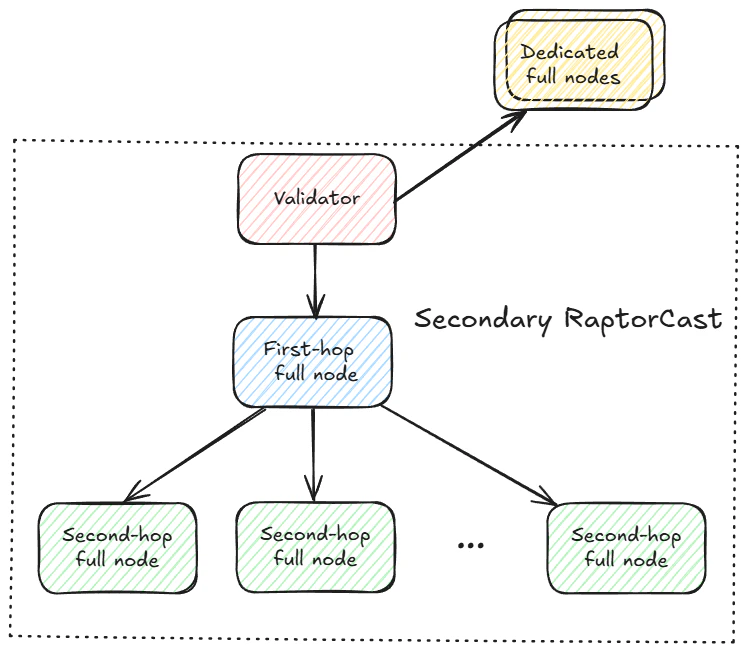
每个验证者在重构提案后,可以通过专用关系或次级 RaptorCast 将所有接收到的(或生成的)数据块传播给全节点。
次级 RaptorCast 反映了上面的主级 RaptorCast 图。在次级 RaptorCast 下,发起者现在是 *任何* 验证者,接收数据块的组是公开和优先化全节点的集合,而不是按质押权重的验证者集合。次级 RaptorCast 中的所有全节点接收相等数量的数据块(不适用质押权重)。
在带宽方面,次级 RaptorCast 比专用全节点更高效,因为验证者的上传带宽要求是恒定的,而不是随着专用全节点的数量线性扩展。与主级 RaptorCast 类似,通过添加第二跳,分发的负担由组中的参与者更均匀地承担。